« Open web ne veut pas dire open bar » : que faire face à la montée des bots IA ?
Le trafic des bots malveillants a progressé de 124 % en un an, selon DataDome. Jérôme Segura, VP of Threat Research de l’entreprise, détaille ce que cachent ces chiffres, de l’usurpation des crawlers IA à l’assaut des pages de connexion.

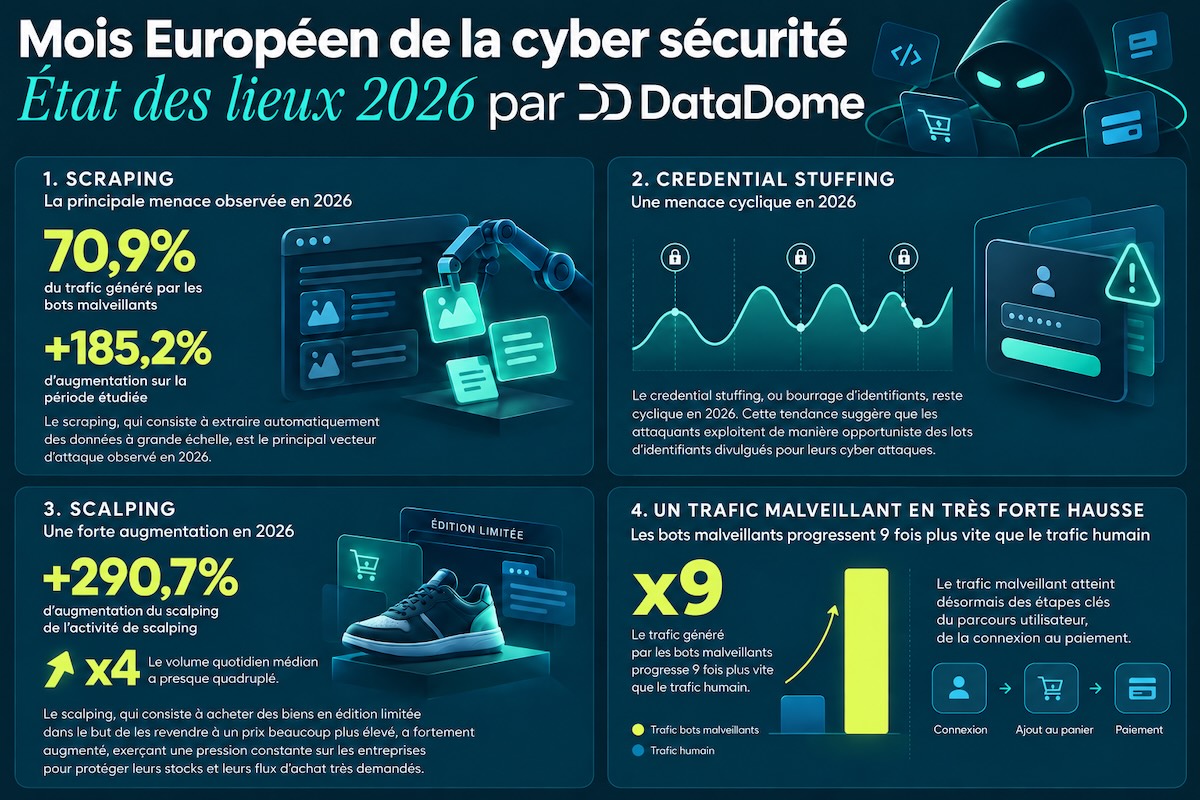
Alors que le mois européen de la cybersécurité vient de débuter, DataDome a publié son état des lieux du trafic web en 2026. Le spécialiste français de la gestion des bots et des agents IA y relève une hausse de 124 % du trafic des bots malveillants en douze mois, soit une croissance 9 fois supérieure à celle du trafic humain. Près de deux sites testés sur trois n’ont pourtant aucune protection contre ces bots.
L’étude s’appuie sur plus de 1 000 milliards de requêtes observées sur plus de 75 000 sites clients et sur des tests menés sur plus de 20 000 sites populaires. Pour en décrypter les résultats, BDM a interrogé Jérôme Segura, VP of Threat Research de DataDome, qui livre au passage des données additionnelles.

Scraping, credential stuffing, scalping : de quoi parle-t-on ?
- Le scraping désigne l’extraction automatisée de données sur un site, à grande échelle.
- Le credential stuffing, ou bourrage d’identifiants, consiste à multiplier les tentatives de connexion à partir de couples identifiant/mot de passe.
- Le scalping vise les produits en édition limitée, achetés pour être revendus beaucoup plus cher.
Scraping : des bots qui ne disent pas leur nom
Premier vecteur d’attaque relevé par l’étude, le scraping représente 71 % du trafic des bots malveillants observé dans la base clients de DataDome. L’entreprise avance l’hypothèse d’un lien avec l’essor de la chaîne d’approvisionnement en données pour l’IA. Reste à savoir qui se cache derrière ces requêtes.
« Il faut d’abord distinguer deux choses :
- Les crawlers déclarés des grands acteurs de l’IA sont bien visibles dans nos données : sur douze mois, nous avons détecté 52,7 milliards de requêtes d’agents IA et de crawlers LLM, dont 46,3 % attribuées à Meta et 34,6 % à OpenAI. Mais ce trafic-là s’annonce, et nos clients peuvent choisir de l’autoriser, de le bloquer ou de le monétiser. Il n’explique pas, à lui seul, la hausse de 185,2 % du scraping malveillant », explique Jérôme Segura.
- « Le gros du volume vient d’acteurs qui ne se déclarent pas : des revendeurs de données, des services de scraping à la demande, des applications qui construisent des agents IA et qui ont besoin de données fraîches pour l’entraînement ou pour générer leurs réponses. D’après nos travaux, 80 % des agents IA ne s’identifient pas correctement lorsqu’ils visitent un site. »
« Et il existe une troisième catégorie, plus dangereuse, poursuit-il : ceux qui se font passer pour des crawlers légitimes. L’usurpation d’agents IA a augmenté de 45 % entre février et juillet 2026. Meta-ExternalAgent est l’identité la plus usurpée, avec 16,4 millions de requêtes frauduleuses rien qu’en février. »
Autrement dit, se fier au nom qu’un bot se donne, c’est lui laisser la porte ouverte.
Dès lors, où placer la frontière entre un agent mandaté par un vrai client et un bot malveillant ? « Ce qui fait la différence, c’est l’intention, et on la déduit en croisant plusieurs signaux. L’agent est-il vraiment celui qu’il prétend être, vérifié par sa signature digitale (Web Bot Auth), ses plages d’IPs, rDNS et non par son simple user-agent ? »
Prenons un exemple concret. Un agent qui compare les prix de trois paires de chaussures pour son utilisateur, à un rythme raisonnable, crée de la valeur pour le marchand. Le même agent qui aspire 50 000 fiches produits en une heure, ou qui tente de réserver 40 paires lors d’une sortie limitée, relève de l’abus, même s’il porte un nom qui à première vue a l’air légitime.
« La question n’est plus « est-ce un bot ou un humain ? », mais « que cherche à faire ce visiteur, et est-ce bénéfique pour mon activité ? » », résume le chercheur.

Agents IA : protéger sans fermer la porte
Le trafic total lié à l’IA a progressé de 82 % sur la période étudiée, mêlant activités utiles et nuisibles. Ce trafic intéresse aussi les marchands, que Google invite à rendre leurs sites utilisables par les agents IA, quitte à alléger certaines barrières.
« Je ne crois pas qu’il faille choisir entre sécurité et ouverture. Le vrai risque serait de répondre à la pression du commerce agentique en supprimant les contrôles, alors qu’il s’agit plutôt de remplacer des barrières obsolètes par des contrôles intelligents », estime Jérôme Segura.
Il faut d’abord définir et publier une politique d’accès pour les agents IA : quels agents sont autorisés, sur quelles pages, à quelles conditions. Ensuite, vérifier les agents et évaluer leur comportement en temps réel. Enfin, graduer selon la sensibilité des pages : un agent de recherche peut explorer le catalogue librement, mais un agent qui veut accéder à un compte ou payer doit être vérifié et rattaché à un utilisateur réel.
« L’enjeu commercial est bien réel : entre janvier et juin 2026, nous avons mesuré 89,4 millions de visites redirigées depuis des assistants IA vers les sites de nos clients, dont 83,4 % depuis ChatGPT. Ce sont des visiteurs très qualifiés, qui arrivent avec une intention d’achat. Bloquer tout le trafic IA peut coûter du chiffre d’affaires mais tout laisser passer augmente l’exposition à la fraude », précise-t-il.
Côté éditeurs, Cloudflare bloque désormais par défaut une partie des crawlers d’entraînement IA et plaide pour faire payer les agents à la page. Jérôme Segura salue le mouvement : « Chaque éditeur doit pouvoir décider qui accède à son contenu, et dans quelles conditions. »
L’open web ne veut pas dire open bar sur les contenus à forte valeur. De ce point de vue, tout ce qui redonne ce pouvoir de décision aux sites va dans le bon sens.
Encore faut-il identifier qui paie. « Un scraper qui se déguise en navigateur ordinaire, ou en crawler autorisé, ne paiera jamais », nuance-t-il. Pour lui, « la détection reste le préalable : on ne peut pas monétiser ce que l’on ne voit pas ».
La page de connexion, nouveau terrain de chasse
Agents légitimes et bots malveillants à la même porte
Selon l’étude, les bots basés sur l’IA ciblent désormais 8 fois plus les pages de connexion. Credential stuffing industrialisé, création de faux comptes ou agents légitimes connectés au nom d’un utilisateur ? Jérôme Segura y voit « les trois à la fois, et c’est précisément ce qui rend la situation délicate ».
Le volume mensuel de requêtes de bots IA sur les pages de connexion est passé de 11,9 millions en janvier 2026 à 99,7 millions en juin. Les pages de connexion représentent désormais 51,7 % du trafic IA dirigé vers des pages sensibles, contre 23 % l’an dernier.
Il relève aussi que « l’usurpation des agents pilotés en direct par un utilisateur, comme ChatGPT-User ou Perplexity-User, est passée d’environ 1,4 % à 5,6 % entre février et juillet 2026 ».
Et de prévenir : « Une connexion avec les bons identifiants n’est pas une preuve de bonne foi. C’est le comportement pendant et après la connexion qu’il faut surveiller, que le visiteur soit un humain, un bot ou un agent IA. »
La France, réservoir d’identifiants volés
Le credential stuffing, lui, est resté cyclique selon l’étude. Un sujet sensible en France, pays européen le plus touché par les fuites de données au premier semestre, selon une étude de Surfshark.
« Notre rapport ne mesure pas de corrélation pays par pays, mais le mécanisme est clair. Le credential stuffing se nourrit directement des fuites : chaque base de données volée alimente des listes d’identifiants que les attaquants testent ensuite en masse sur d’autres sites, en pariant sur la réutilisation des mots de passe. Avec 43,4 millions de comptes piratés entre janvier et juin 2026, la France constitue un réservoir considérable », observe Jérôme Segura.
Il cite aussi le cas de la DGFiP (Direction générale des Finances publiques) : « Selon le rapport publié par l’ANSSI le 29 septembre, les vols de données au fisc cet été ne sont pas le fruit d’une attaque sophistiquée : les pirates se sont servis d’identifiants d’agents dérobés, probablement par des logiciels espions sur des ordinateurs personnels, pour accéder à des portails dépourvus d’authentification multifacteur. »
Le cycle que nous observons est cohérent avec ce fonctionnement : une campagne très intense à l’été 2025, un effondrement de près de 90 % dans les trois mois suivants, puis un retour complet début 2026, jusqu’à de nouveaux records quotidiens en avril.

Scalping : une pression devenue permanente
Autre vecteur en forte hausse selon l’étude, le scalping. Quels marchés sont visés ? « Notre rapport ne ventile pas le scalping par secteur, mais ce que nous voyons chez nos clients correspond aux marchés où l’offre est rare et la revente lucrative : la billetterie de concerts et d’événements sportifs, les sneakers et le streetwear en édition limitée, et plus largement tous les drops : consoles, cartes à collectionner, figurines, collaborations exclusives », répond Jérôme Segura.
Ce qui frappe dans les chiffres 2026, ce n’est pas seulement la hausse de 290,7 %, c’est que l’activité ne se limite plus aux grands lancements. Le volume quotidien médian a presque quadruplé : le scalping est devenu une pression permanente, ponctuée de pics lors des sorties.
Ces outils sont-ils devenus accessibles à des revendeurs sans compétences techniques ? « Sur l’accessibilité, oui, la barrière à l’entrée s’est effondrée. Il existe des plateformes de bot-as-a-service peu coûteuses et sans code, des bots de revente vendus clés en main avec des proxies résidentiels, et l’IA générative permet d’écrire ou d’adapter un script en quelques minutes. Un revendeur n’a plus besoin d’être développeur. En face, 64,2 % des sites de billetterie que nous avons testés ne sont pas protégés. »

Des protections à la traîne
Côté défenses, le constat de l’étude est sévère. Lors des tests approfondis, 65 % des sites n’ont bloqué aucun des 10 types de bots évalués. Seuls 2,4 % les ont tous arrêtés, contre 8,4 % en 2024 et 2,8 % en 2025. Négligence, choix délibéré d’ouvrir la porte aux IA ou bots devenus trop difficiles à repérer ? « C’est rarement un choix délibéré. C’est surtout un décalage entre la protection que les entreprises pensent avoir et celle qu’elles ont réellement », indique Jérôme Segura.
Il pointe notamment « un faux sentiment de sécurité » : « Beaucoup de sites s’appuient sur des règles basiques, comme la réputation d’IP ou le filtrage des user-agents, intégrées à leur CDN ou à leur pare-feu. Or, seuls 5,5 % des sites testés arrêtent tous les bots de base, c’est-à-dire les plus simples à détecter. » Plus encore, d’après lui, « sept sites sur dix laissent passer un faux agent IA simplement parce qu’il se présente comme GPTBot ou ClaudeBot ».
« L’ouverture volontaire aux IA existe, mais elle se fait souvent à l’aveugle : un site qui autorise GPTBot sans vérifier que c’est bien lui ouvre la porte à tous ceux qui l’imitent. Enfin, ce n’est pas une question de moyens, les entreprises de plus de 10 000 salariés affichent un taux d’absence de protection de 64,6 %, légèrement moins bon que les plus petites structures (62,7 %). »
À l’échelle régionale, l’Europe affiche le deuxième taux d’absence de protection le plus élevé, derrière l’Asie-Pacifique. « Il faut aussi rappeler qu’aucune région ne progresse : l’Europe passe de 61,5 % à 66,7 % de sites non protégés, l’Amérique du Nord de 59,8 % à 63,8 %, et l’Asie-Pacifique atteint 73,9 %. Les attaquants réutilisent les mêmes outils sur tous les marchés. »
Pour la France, pays européen le plus touché par les fuites de données, cette faiblesse est particulièrement préoccupante.
Serveurs MCP et premiers réflexes
Dernier front, les serveurs MCP (Model Context Protocol), que DataDome cite parmi les surfaces qu’il protège. Deviennent-ils une nouvelle surface d’attaque ? « Oui, le MCP devient la couche de connexion entre les agents IA et les services des entreprises. C’est une nouvelle porte d’entrée, souvent ouverte rapidement et encore largement non surveillée. »
Le parallèle avec les API il y a dix ans est frappant : on les a exposées pour aller vite, avant de découvrir qu’elles étaient devenues la cible préférée des bots. Une protection qui couvre la page d’accueil mais oublie la page de connexion, l’application mobile ou un endpoint MCP est incomplète.
Pour un média ou une PME sans budget dédié à la sécurité, Jérôme Segura recommande d’avancer par étapes :
- « Dans un premier temps, regagner de la visibilité. On ne peut pas protéger ce que l’on ne voit pas. La première étape consiste à savoir quelle part de son trafic est automatisée et ce que font ces bots. »
- « Ensuite, prioriser. Il faut commencer par les points qui concentrent le risque : la connexion, la création de compte, les formulaires et le paiement. Sur ces pages, quelques mesures de base font déjà une vraie différence : double authentification, limitation du nombre de tentatives, refus des mots de passe déjà compromis. »
Il met enfin en garde : « Le robots.txt est une déclaration d’intention, pas une protection : beaucoup de bots l’ignorent. »
Jérôme Segura, VP of Threat Research, DataDome
Jérôme Segura est VP of Threat Research chez DataDome depuis juillet 2025. Il a auparavant passé plus de dix ans chez Malwarebytes, où il a notamment occupé le poste de Senior Director of Research. Ses recherches portent sur les menaces web, du malvertising à l’ingénierie sociale, et désormais sur l’usurpation d’identité des agents IA.
Cet article est gratuit, mais réservé aux membres
Pas encore de compte ?
- 100 % des articles BDM
- La newsletter des pros du digital
- Le calendrier marketing en PDF
- Et tous nos guides
Les meilleurs outils Bot management

Cloudflare Bot Management
Datadome

Netacea Bot Management