

Les meilleurs modèles pour piloter des agents IA en novembre 2026
Les modèles d’Anthropic dominent toujours l’Agent Arena, un benchmark collaboratif qui mesure l’aptitude des IA à orchestrer des tâches agentiques.
En novembre 2026, les modèles conçus par Anthropic demeurent les plus performants pour orchestrer des tâches agentiques, devant ceux de Google ou d’OpenAI. C’est ce que révèle la mise à jour de l’Agent Arena, un classement piloté par Arena (ex-LMArena, ex-Chatbot Arena). Mis en ligne en juin dernier, ce benchmark collaboratif mesure les performances de ces technologies à partir des centaines de milliers d’interactions enregistrées dans son environnement sandbox, où les utilisateurs peuvent déléguer des tâches complexes en plusieurs étapes à des agents autonomes.
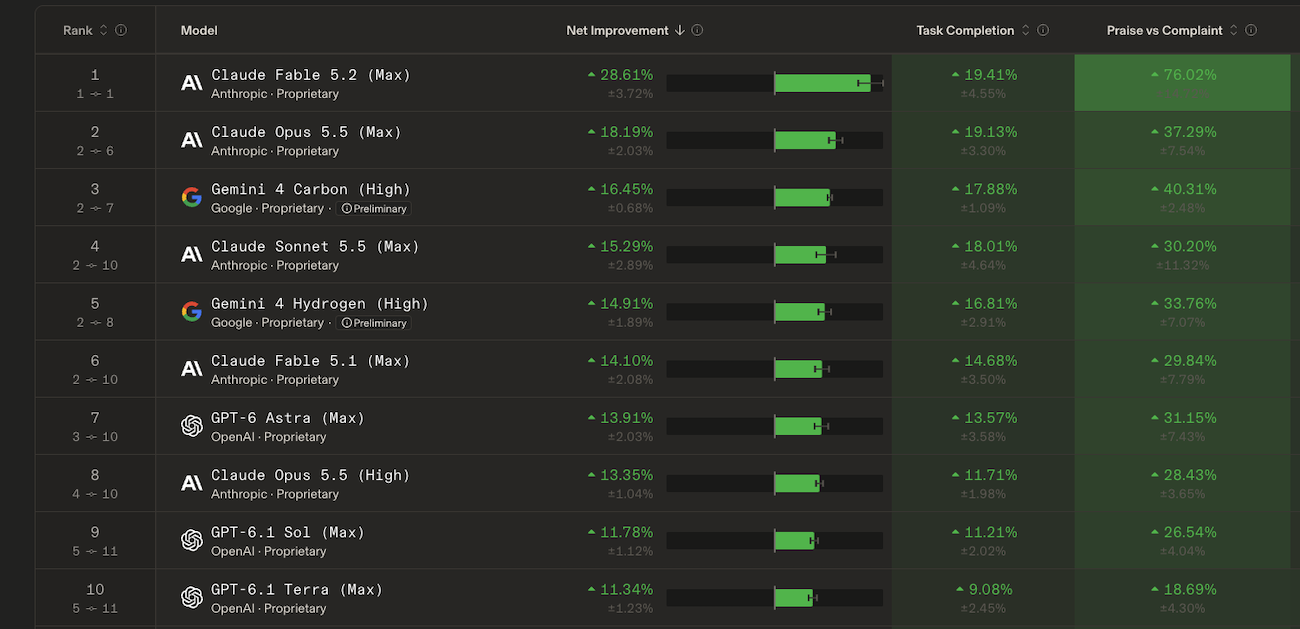
Les 10 modèles d’IA les plus performants pour orchestrer des tâches agentiques en novembre 2026
Dévoilé lundi dernier, Claude Fable 5.2 se hisse sans mal en tête du classement établi par Arena. Évalué avec un niveau de réflexion configuré sur « Max », comme la plupart de ses concurrents, le modèle de la firme californienne affiche un score de Net Improvement de 28,6 %, contre 18,1 % pour Claude Opus 5.5, auquel il succède en tête du classement. Pour obtenir ce score, Arena agrège l’ensemble des signaux recueillis pendant les tests, puis compare le résultat à celui du « modèle moyen ». « Un score positif indique une performance supérieure à la moyenne, un score négatif une performance inférieure », précise la plateforme. Autrement dit, Claude Fable 5.2 se montre 28,6 % plus performant que la moyenne sur les tâches qui lui sont confiées.
L’autre enseignement notable du mois : en matière d’IA agentique, Google semble combler progressivement son retard. Gemini 4 Carbon, le modèle le plus abouti de la firme, toujours réservé à un cercle restreint d’acteurs de la cyberdéfense, se hisse sur la troisième marche du podium. Le géant de Mountain View réussit aussi à placer Gemini 4 Hydrogen, fraîchement déployé sur Gemini, l’API et le moteur de recherche, au quatrième rang, entre Claude Sonnet 5.5 et Claude Fable 5.1. En revanche, Gemini 4 Argon, quatrième le mois dernier, sort du top 10, qui est complété par trois modèles d’OpenAI : GPT-6 Astra (7e), GPT-6.1 Sol (9e) et GPT-6.1 Terra (10e).
Découvrez les 10 modèles les plus performants pour piloter des agents IA en novembre 2026 :
- Claude Fable 5.2 « Max » (Anthropic)
- Claude Opus 5.5 « Max » (Anthropic)
- Gemini 4 Carbon « High » (Google)
- Claude Sonnet 5.5 « Max » (Anthropic)
- Gemini 4 Hydrogen « High » (Google)
- Claude Fable 5.1 « Max » (Anthropic)
- GPT-6 Astra « Max » (OpenAI)
- Claude Opus 5.5 « High » (Anthropic)
- GPT-6.1 Sol « Max » (OpenAI)
- GPT-6.1 Terra « Max » (OpenAI)
Comment Arena évalue-t-il les modèles d’IA sur les tâches agentiques ?
L’équipe d’Arena s’appuie sur une méthodologie baptisée causal tracing, distincte de celle employée pour son classement général. La plateforme analyse des millions de sessions conduites dans son Mode Agent, un environnement sandbox où les utilisateurs confient des workflows à un agent doté de divers outils (recherche web, génération d’images, etc.). Afin de départager les modèles, Arena change au hasard, d’une session à l’autre, celui qui pilote l’agent.
Arena évalue si l’utilisateur approuve ou rejette les résultats, s’il complimente ou dénigre l’agent dans ses messages, s’il s’améliore lorsqu’on le reprend, le nombre d’essais nécessaires après une requête infructueuse et s’il crée des outils qui n’existent pas.


LinkedIn en 2026 : participez à notre enquête
Quelle est votre relation à LinkedIn ? Participez à notre court sondage pour partager votre point de vue !
Je participeLes meilleurs agents IA
Dify
Muse
Goose
 Se connecter à BDM avec Google

