Top 20 des modèles d’IA les plus performants en octobre 2026
Après plusieurs mois de règne sans partage sur Arena, benchmark collaboratif de référence, Anthropic se fait détrôner par Google et Meta.
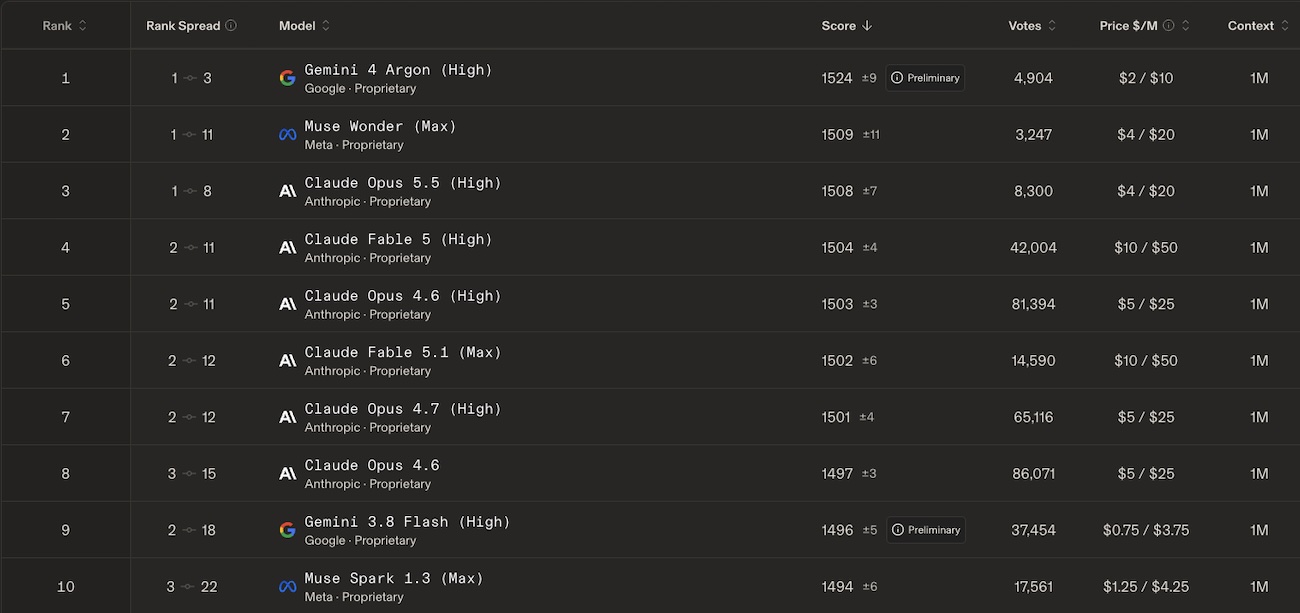
Pour la première fois depuis plusieurs mois, Anthropic cède la tête du classement Text Arena, qui évalue en temps réel les performances des modèles d’IA sur des tâches comme les mathématiques, le code ou l’écriture créative. Gemini 4 Argon, récemment déployé par Google auprès de ses abonnés payants, s’empare de la première place, devant Muse Wonder. La société créatrice de Claude place tout de même six modèles dans la première partie de tableau.
Les 20 modèles d’IA les plus performants en octobre 2026
Présenté début octobre et d’abord réservé à une poignée d’acteurs de la cyberdéfense, Gemini 4 Argon a visiblement séduit la communauté d’Arena, un benchmark collaboratif où les internautes arbitrent des duels entre deux modèles anonymes (voir plus bas). Conçu pour les tâches longues et complexes, en plusieurs étapes, le modèle le plus avancé de la firme de Mountain View devance Muse Wonder, dévoilé par Meta la semaine dernière et qui revendique lui aussi cette spécialité.
Derrière, Anthropic accapare l’essentiel de la première partie de tableau. Claude Opus 5.5 prend la troisième place, devant Claude Fable 5, la version « High » de Claude Opus 4.6 — qui se maintient dans les cinq premières positions malgré une sortie remontant à février —, Claude Fable 5.1, Claude Opus 4.7 et la version standard de Claude Opus 4.6. Gemini 3.8 Flash et Muse Spark 1.3 complètent le top 10.
Et OpenAI, dans tout ça ? La société créatrice de ChatGPT est toujours loin derrière : son premier modèle, GPT-5.6 Sol, n’apparaît qu’au 21e rang. À l’exception de Moonshot, qui place Kimi K3 en 18e position, le top 20 est désormais monopolisé par Meta, Google et Anthropic.
Voici les 20 modèles d’IA les plus performants sur les tâches text-to-text selon Arena :
- Gemini 4 Argon « High »
- Muse Wonder « Max »
- Claude Opus 5.5 « High »
- Claude Fable 5 « High »
- Claude Opus 4.6 « High »
- Claude Fable 5.1 « High »
- Claude Opus 4.7 « High »
- Claude Opus 4.6
- Gemini 3.8 Flash « High »
- Muse Spark 1.3 « Max »
- Claude Opus 4.7
- Muse Spark 1.2 « xHigh »
- Muse Spark 1.1
- Claude Opus 5 « Max »
- Claude Opus 5 « High »
- Muse Spark
- Gemini 3.7 Flash « High »
- Kimi K3 « Max »
- Gemini 3.1 Pro Preview
- Gemini 3 Pro
Les meilleurs modèles d’IA par catégorie en octobre 2026
Arena évalue aussi les modèles sur des tâches plus ciblées, comme la recherche web, l’analyse d’images, l’analyse de documents. Voici les résultats dans chacune de ces catégories :
- Recherche web : la version « xHigh » de GPT-5.6 Sol domine cette catégorie. Qwen 3.8 Max et Claude Opus 4.6 Search complètent le podium. Sur les dix premières places, neuf reviennent à Anthropic (5) et OpenAI (4).
- Analyse d’images : Claude Fable 5 prend la tête, devant Qwen 3.8 et Claude Opus 4.6. Anthropic place 5 modèles dans le top 10.
- Analyse de documents : Claude Opus 5 arrive en tête d’une catégorie où Anthropic monopolise les 7 premières places. OpenAI complète le top 10 avec GPT-5.5 en version standard, GPT-5.5 « High » et GPT-5.6 Sol.

Les critères de classement d’Arena
Scruté par les principaux acteurs et observateurs de l’IA, Arena est un benchmark collaboratif qui s’appuie sur les votes des internautes pour hiérarchiser les modèles. Le principe ? Une requête est soumise à deux modèles anonymisés, qui produisent chacun une réponse et l’utilisateur désigne la plus pertinente. Chaque modèle se voit attribuer un score Elo, une sorte de cote qui varie selon ses performances lors de ces duels. Une victoire contre un adversaire mieux classé lui rapporte des points, tandis qu’une défaite face à un concurrent moins bien classé en fait perdre. Un modèle en tête du classement peut toujours améliorer son score, mais sa progression est plus lente.
Les meilleurs agents IA
Dify
Goose
Noah