Top 20 des modèles d’IA les plus performants en septembre 2026 : le classement complet
En septembre, les modèles d’Anthropic campent sept des dix premières positions du classement des meilleurs modèles d’IA établi par Arena.
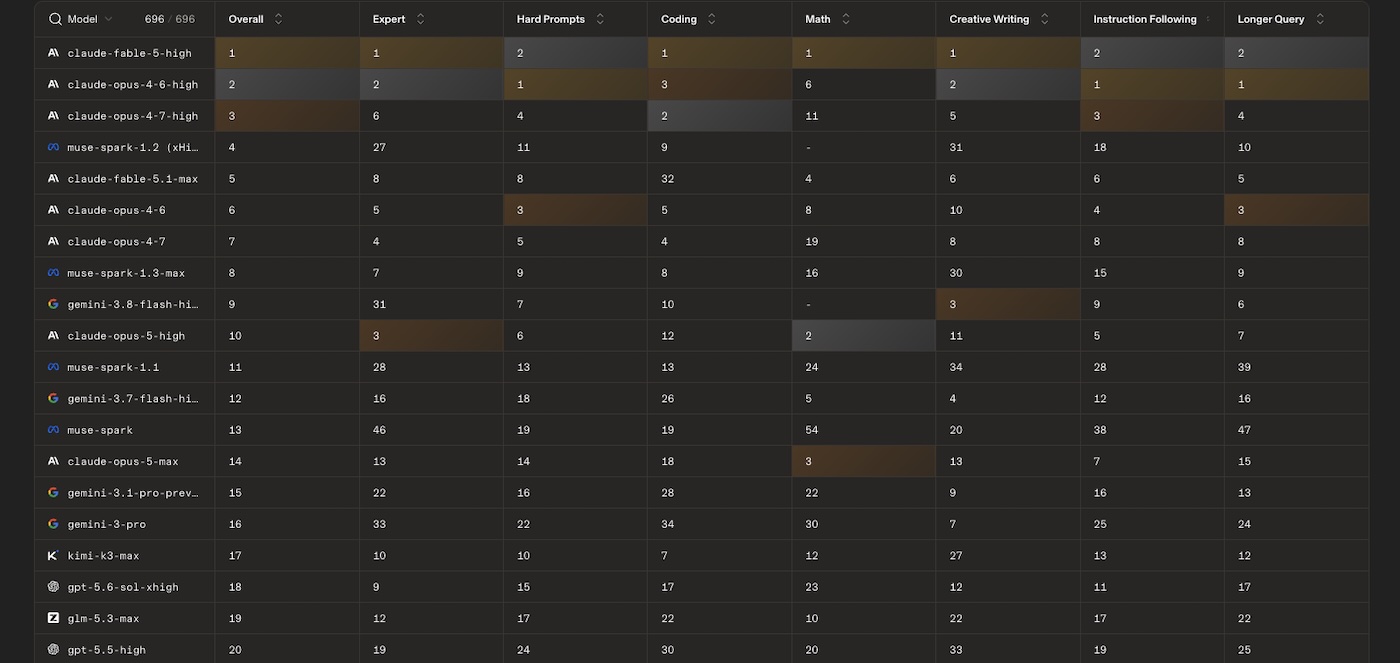
Les mois se suivent et se ressemblent pour Anthropic, dont les grands modèles de langage continuent de dominer sans partage le classement établi par Arena. En septembre 2026, la société créatrice de Claude place sept modèles dans les dix premières positions de ce benchmark collaboratif, alimenté par les contributions des utilisateurs, qui départagent au fil de duels les performances de modèles dont ils ignorent l’identité. Derrière, Meta et Google se partagent les miettes, tandis qu’OpenAI parvient tout juste à hisser deux de ses modèles, GPT-5.6 Sol et GPT-5.5 en l’occurrence, dans le top 20.
Les 20 modèles d’IA les plus performants en septembre 2026
Comme le mois dernier, Claude Fable 5, première version de la classe Mythos rendue accessible au grand public, occupe la première place, toujours devant Claude Opus 4.6 et Claude Opus 4.7, qui s’accrochent au podium malgré une sortie déjà ancienne. Curiosité du classement : Claude Fable 5.1, dévoilé début septembre, ne fait pas mieux qu’une cinquième place.
Le petit dernier de la gamme d’Anthropic se fait même coiffer par Muse Spark 1.2, le modèle de Meta sorti en août qui notamment Muse Code, un agent de programmation autonome. Le groupe de Menlo Park glisse d’ailleurs un second modèle dans le top 10 avec Muse Spark 1.3. Huitième, il devance Gemini 3.8 Flash, l’ultime représentant de Google au sein de la première partie de tableau. Après avoir massivement investi dans ses infrastructures et débauché des chercheurs et des cadres à la concurrence, le groupe de Mark Zuckerberg paraît revenir peu à peu dans la course.
Pour trouver un modèle d’OpenAI, en revanche, il faut scroller un peu : GPT-5.6 Sol ne se classe que dix-huitième, et GPT-5.5 vingtième. On relèvera aussi la présence dans le top 20 de Kimi K3 et de GLM 5.3, deux modèles d’origine chinoise.
Voici les 20 modèles de langage les plus performants en septembre 2026, toutes tâches confondues :
- Claude Fable 5 « high »
- Claude Opus 4.6 « high »
- Claude Opus 4.7 « high »
- Muse Spark 1.2 « xhigh »
- Claude Fable 5.1 « max »
- Claude Opus 4.6
- Claude Opus 4.7
- Muse Spark 1.3 « max »
- Gemini 3.8 Flash « high »
- Claude Opus 5 « high »
- Muse Spark 1.1
- Gemini 3.7 Flash « high »
- Muse Spark
- Claude Opus 5 « max »
- Gemini 3.1 Pro
- Gemini 3 Pro
- Kimi K3 « max »
- GPT 5.6 Sol « high »
- GLM 5.3 « max »
- GPT-5.5 « high »
Les meilleurs modèles d’IA par catégorie en septembre 2026
En parallèle du classement général, Arena évalue également les modèles sur plusieurs tâches spécifiques, afin de cerner les atouts de chacun. Anthropic et OpenAI dominent la plupart des catégories ce mois-ci :
- Développement web : dépeint par OpenAI comme son meilleur modèle créé à ce jour pour le développement logiciel, GPT-6 Astra se hisse en tête du classement WebDev, devant Claude Fable 5.1 Max et Claude Opus 5 Max.
- Analyse d’image : en matière de « vision », Claude Fable 5 s’impose comme le modèle le plus performant, devant Qwen 3.8 et la version « high » de Claude Opus 4.7. Meta place trois modèles dans le top 10.
- Analyse de documents : les sept premières positions de cette catégorie sont occupées par des modèles d’Anthropic, Claude Opus 5 ouvrant la marche. Trois modèles d’OpenAI complètent le top 10
- Génération d’images : déployées il y a quelques jours à peine, les versions « flare » et « sunburst » de ChatGPT Images 2.5 trustent la tête du classement Text-to-image et relèguent leur prédécesseur à la troisième place. En quatrième position, on retrouve le modèle de Microsoft MAI Image 2.6.
- Recherche web : avec 1 257 d’Elo, GPT-5.6 Sol garde une courte longueur d’avance sur la version « search » de Claude Opus 4.6. Le reste du top 10 réunit notamment GPT-5.5 Search, Claude Fable 5 et Gemini 3.1 Pro.

Les critères de classement d’Arena
Pour jauger objectivement les performances des modèles, Arena s’en remet à ses utilisateurs. La plateforme organise des affrontements entre deux modèles à l’identité masquée, autour d’un même prompt. À l’utilisateur, ensuite, de désigner celui qui s’en tire le mieux. Chaque modèle se voit attribuer un score Elo, qui évolue selon l’issue des confrontations. Une victoire sur un concurrent mieux classé permet d’engranger des points, tandis qu’une défaite face à un modèle supposément plus faible en fait perdre.
Les meilleurs générateurs de texte par IA
Lumo
Euria
ChatGPT