


IA : les meilleurs modèles pour le code et le développement web en novembre 2026
Grâce à Claude Opus 5.5, Anthropic conserve la tête de la WebDev Arena. Mais OpenAI, Google, Meta et Moonshot se rapprochent dangereusement.
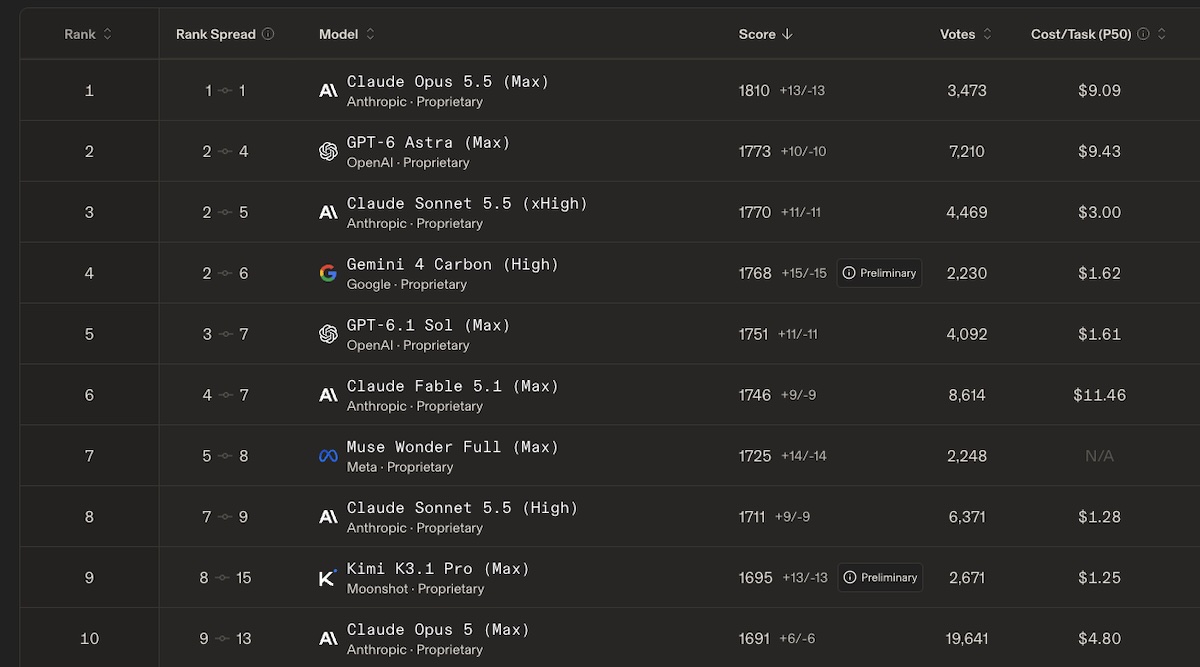
En novembre, Anthropic conserve la première place de la WebDev Arena, mais ses concurrents gagnent du terrain. C’est le principal enseignement de la dernière mise à jour de ce benchmark collaboratif, fondé sur des duels anonymisés, dans lequel les utilisateurs comparent les performances des modèles des principaux laboratoires d’IA en matière de code et de développement web.
Claude Opus 5.5 résiste, la concurrence s’organise
Premier en octobre, Claude Opus 5.5 devance toujours GPT-6 Astra, le modèle le plus avancé d’OpenAI. Dévoilé la semaine dernière et actuellement testé par un nombre restreint d’acteurs de la cyberdéfense, Gemini 4 Carbon, conçu par Google, complète le podium. À noter que Gemini 4 Argon, qui occupait la neuvième place le mois dernier et vient tout juste d’être déployé auprès des abonnés payants de Gemini, ne figure plus dans le top 10.
Autrefois chasse gardée des modèles d’Anthropic, le haut du classement de la WebDev Arena réunit désormais cinq acteurs. Meta parvient notamment à hisser Muse Wonder Full, accessible via son API et via Muse Code depuis le début du mois d’octobre, à la septième place, juste derrière Claude Fable 5.1. La startup chinoise Moonshot réussit également à faire entrer Kimi K3.1 Pro dans le top 10, au neuvième rang. Anthropic y place néanmoins quatre modèles et reste, de loin, l’acteur le mieux représenté.
Voici les dix modèles d’IA les plus performants pour le code et le développement web en novembre 2026 :
- Claude Opus 5.5 « Max » (Anthropic) : 1 810 (score Elo)
- GPT-6 Astra « Max » (OpenAI) : 1 773
- Claude Sonnet 5.5 « xHigh » (Anthropic) : 1 770
- Gemini 4 Carbon « High » (Google) : 1 768
- GPT-6.1 Sol « Max » (OpenAI) : 1 751
- Claude Fable 5.1 « Max » (Anthropic) : 1 746
- Muse Wonder Full « Max » (Meta) : 1 725
- Claude Sonnet 5.5 « High » (Anthropic) : 1 711
- Kimi K3.1 Pro « Max » (Moonshot AI) : 1 695
- Claude Opus 5 « Max » (Anthropic) : 1 691
OpenAI s’impose en fullstack, Anthropic en front-end
En complément de son classement général, la WebDev Arena évalue les modèles des laboratoires d’IA sur deux catégories de tâches : le développement fullstack et le développement front-end.
En matière de développement fullstack, OpenAI mène les débats : GPT-6 Astra et GPT-6.1 Sol occupent les deux premières marches du podium, devant Claude Opus 5.5. Le classement front-end, qui évalue notamment les modèles sur le raisonnement en plusieurs étapes, l’appel d’outils ou la génération de code HTML ou React, tourne en revanche à l’avantage d’Anthropic. Claude Opus 5.5 s’y impose, devant Claude Sonnet 5.5. Gemini 4 Carbon complète le podium. Ces deux classements reposent toutefois sur un nombre de votes inférieur à celui du classement général. Leurs résultats appellent donc davantage de prudence.

Les critères de classement de WebDev Arena
Pour jauger les performances des modèles, Arena s’en remet à ses utilisateurs. Sur la plateforme, l’organisme orchestre des duels anonymisés : chaque modèle reçoit la même consigne, et l’utilisateur vote pour le résultat qui lui semble la plus abouti, sans connaître l’identité de celui qui l’a généré. Chaque modèle se voit attribuer un score Elo, une sorte de cote qui évolue au fil des rencontres. Un duel remporté contre un adversaire mieux classé permet d’engranger des points, tandis qu’une défaite contre un concurrent supposément plus faible en fait perdre. Le modèle en tête du classement peut encore gagner des points, mais à un rythme moins élevé.
Les meilleurs générateurs de code par IA
Claude Code
Lovable
Jules
 Se connecter à BDM avec Google

