Les meilleurs modèles pour piloter des agents IA en octobre 2026
Claude Opus 5.5 succède à Fable 5.1 au sommet du classement des agents IA d’Arena. Sur le nouvel indice d’alignement, les cinq premières places reviennent pourtant à OpenAI.

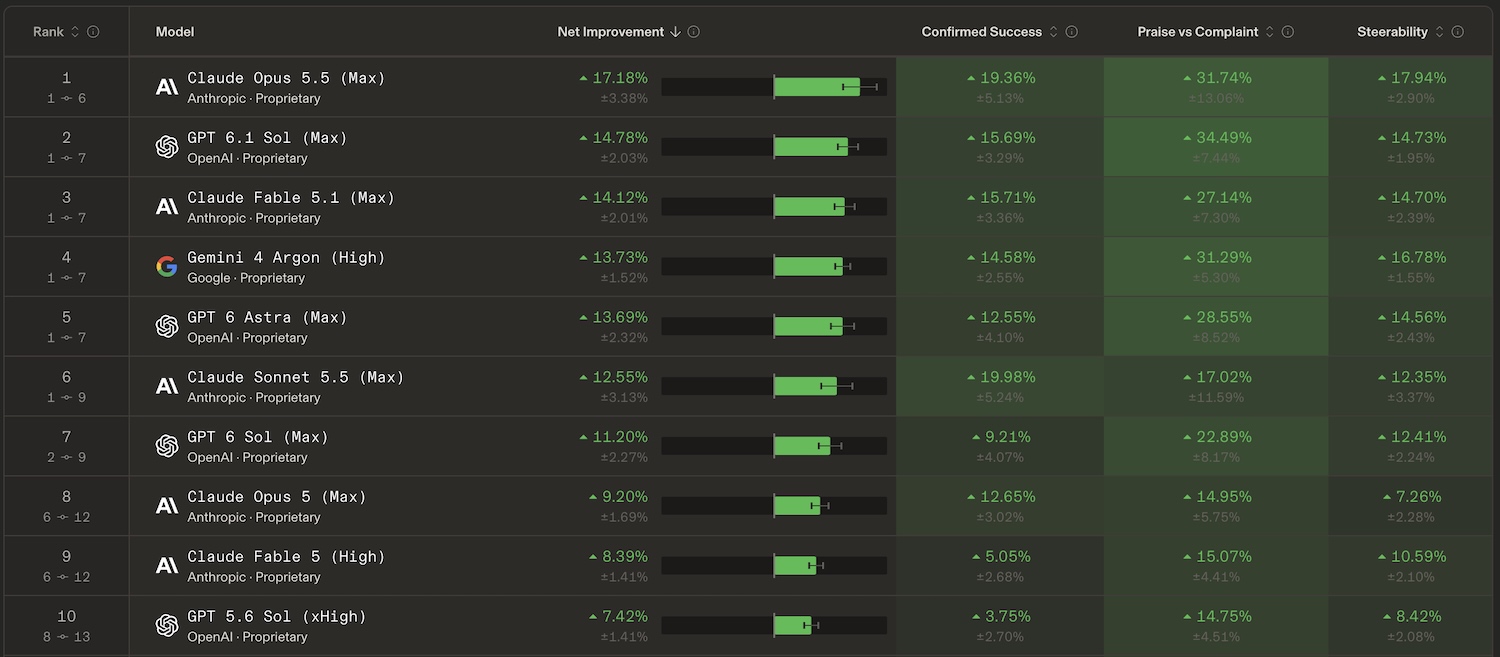
Claude Opus 5.5 prend la tête de l’Agent Arena, qui départage les modèles de langage selon leur capacité à piloter un agent autonome. Il relègue Claude Fable 5.1, premier en septembre, au troisième rang. Entre les deux s’intercale GPT-6.1 Sol, la mise à jour de GPT-6 Sol dévoilée par OpenAI lors de son DevDay du 29 septembre. La plateforme publie aussi son premier indice d’alignement, qui compte les fois où un agent sort de son périmètre ou décrit mal le travail accompli, et dont le haut du tableau revient entièrement à OpenAI.
Top 10 des modèles pour agents IA : cinq nouveaux venus en octobre 2026
Disponible depuis le 22 septembre et évalué en mode Max, Opus 5.5 devance l’ensemble des modèles du tableau, y compris Claude Fable 5.1, facturé deux fois et demie plus cher via l’API. Avec son nouveau Gemini 4 Argon, quatrième, Google signe la plus forte progression du mois. Son meilleur représentant, Gemini 3.6 Flash, pointait au 34e rang il y a un mois. Claude Sonnet 5.5, sixième, et GPT-6 Sol, septième, s’ajoutent à Opus 5.5 et GPT-6.1 Sol parmi les nouveaux entrants.
Les cinq modèles déjà présents en septembre reculent tous : GPT-6 Astra passe de la deuxième à la cinquième place, Claude Opus 5 de la troisième à la huitième, Claude Fable 5 de la cinquième à la neuvième et GPT-5.6 Sol de la septième à la dixième. Claude Opus 4.8, Kimi K3, Claude Sonnet 5 et GPT-5.5 disparaissent du top 10, où Anthropic aligne désormais cinq modèles, OpenAI quatre et Google un. Arena publie pour chaque modèle une fourchette de rang possible, et celles des cinq poursuivants d’Opus 5.5 incluent toutes la première place.
Voici les 10 modèles les plus performants pour les agents IA en octobre 2026 (voir image de une) :
- Claude Opus 5.5 (Max)
- GPT-6.1 Sol (Max)
- Claude Fable 5.1 (Max)
- Gemini 4 Argon (High)
- GPT-6 Astra (Max)
- Claude Sonnet 5.5 (Max)
- GPT-6 Sol (Max)
- Claude Opus 5 (Max)
- Claude Fable 5 (High)
- GPT-5.6 Sol (xHigh)
Consulter le classement complet sur Arena
Code, chat, travail : Claude Opus 5.5 en tête des trois catégories
Arena décline son classement selon le type de tâche confiée à l’agent. Code regroupe le développement, le débogage, l’automatisation et l’analyse de données. Chat couvre des usages plus personnels, de l’écriture créative aux recherches du quotidien. Work rassemble les tâches de bureau, comme la création de documents ou la rédaction professionnelle. Claude Opus 5.5 arrive premier dans les trois catégories.
Code : Claude Sonnet 5.5 monte sur le podium
Claude Sonnet 5.5 se distingue en développement : troisième de la catégorie, il gagne trois places par rapport au classement général, tandis que Gemini 4 Argon sort du top 5.
- Claude Opus 5.5 (Max)
- GPT-6.1 Sol (Max)
- Claude Sonnet 5.5 (Max)
- Claude Fable 5.1 (Max)
- GPT-6 Astra (Max)
Chat : Gemini 4 Argon deuxième
Gemini 4 Argon se hisse au deuxième rang, juste derrière Opus 5.5. GPT-6.1 Sol, deuxième du classement général, tombe à la cinquième place. La fourchette de classement d’Opus 5.5 y est aussi plus large qu’ailleurs, de la première à la douzième place.
- Claude Opus 5.5 (Max)
- Gemini 4 Argon (High)
- Claude Fable 5.1 (Max)
- GPT-6 Astra (Max)
- GPT-6.1 Sol (Max)
Work : le même top 5 qu’au classement général
La catégorie Work, qui concentrait 69 % des tâches lors du lancement des catégories mi-août, reproduit à l’identique le top 5 du classement général.
- Claude Opus 5.5 (Max)
- GPT-6.1 Sol (Max)
- Claude Fable 5.1 (Max)
- Gemini 4 Argon (High)
- GPT-6 Astra (Max)
Sur l’alignement, OpenAI rafle les cinq premières places
Depuis le 8 octobre, Arena publie aussi un indice d’alignement, une notion que nous détaillions récemment sur BDM. Il mesure la fréquence de trois écarts dans les sessions réelles de l’Agent Arena :
- L’action non autorisée, quand l’agent dépasse la demande de l’utilisateur ou ses permissions,
- La fausse attribution, quand il prête à l’utilisateur des propos ou des choix que les échanges contredisent,
- La complétion trompeuse, quand il annonce une tâche terminée alors qu’elle ne l’est pas.
Sur les 27 modèles évalués, voici les cinq mieux alignés :
- GPT-6.1 Sol
- GPT-6 Astra
- GPT-6 Luna
- GPT-6 Sol
- GPT-5.6 Sol
Claude Opus 5.5, premier modèle d’Anthropic, n’arrive que sixième, et Gemini 4 Argon onzième. Selon Arena, une complétion trompeuse touche en moyenne 10 % des sessions et jusqu’à 48 % en débogage de code.

Des sessions réelles plutôt que des duels à l’aveugle
Contrairement aux autres classements d’Arena, celui consacré aux tâches agentiques ne fait pas voter les internautes entre deux réponses anonymes. Il exploite l’usage réel d’Agent Mode, l’environnement isolé où les utilisateurs confient des tâches complètes à un agent outillé. Chaque session est attribuée au hasard à l’un des modèles, ce qui permet de mesurer l’effet propre de chacun. Cinq des signaux qui composent le score global sont publiés en détail :
- Les tâches confirmées comme réussies par l’utilisateur,
- La part de réactions positives face aux plaintes,
- La prise en compte des corrections,
- La fiabilité des commandes shell,
- Les appels à des outils absents de l’environnement.
Dans le top 10, Opus 5.5 est le plus performant sur la prise en compte des corrections, Sonnet 5.5 recueille le plus de validations et GPT-6.1 Sol le meilleur ratio de réactions positives.
Les meilleurs agents IA
Dify
Goose
Noah