IA : les 10 générateurs d’images les plus performants en octobre 2026
OpenAI garde la main sur les classements images d’Arena. Derrière son podium, Nano Banana 2.1, Krea 3 Ultra et l’amélioration de Grok Imagine 2.0 rebattent les cartes.

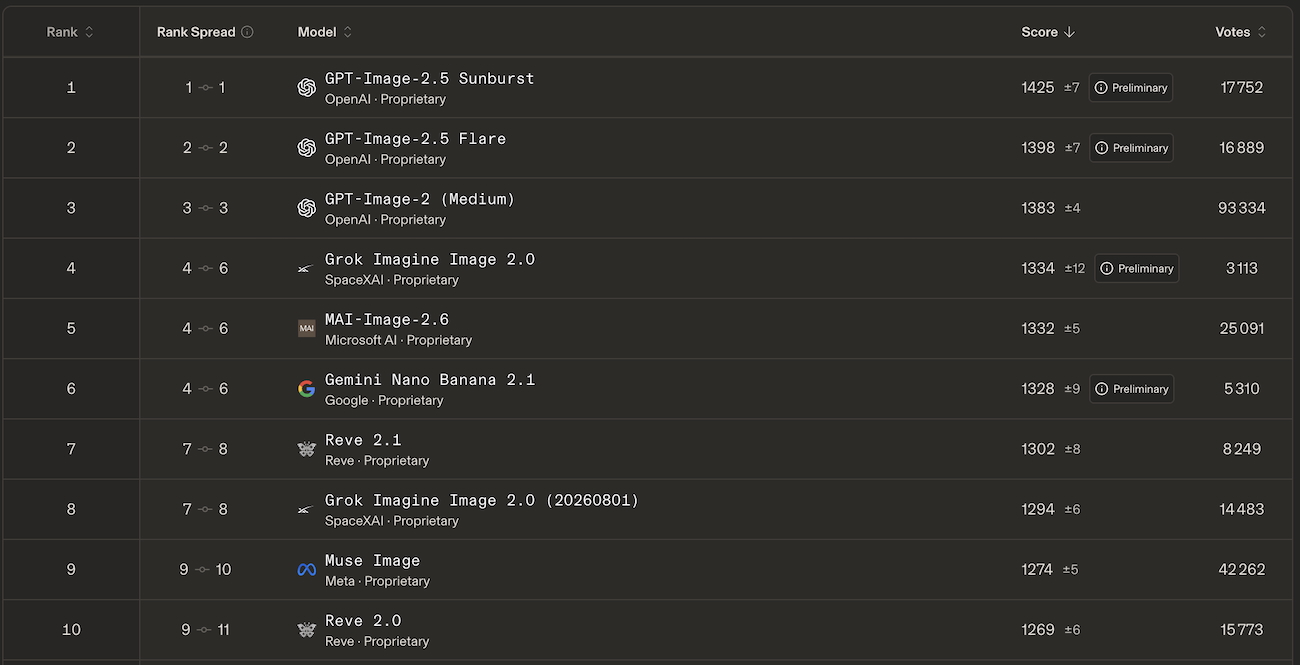
Pour le deuxième mois consécutif, OpenAI monopolise le podium de la Text-to-Image Arena, le classement d’Arena qui départage les générateurs d’images à partir des votes des internautes. GPT Image 2.5 Sunburst reste premier, devant la version Flare et GPT Image 2, comme dans l’édition de septembre. Derrière, deux modèles tout juste ajoutés au tableau, signés Google et SpaceXAI, s’installent d’emblée dans le top 6.
Les 10 générateurs d’images les plus performants en octobre 2026
Lancé le 6 octobre, Nano Banana 2.1 est une mise à jour de Nano Banana 2, le modèle d’images de Google, connu dans l’API sous le nom de Gemini 3.1 Flash Image. Il entre à la sixième place, avec un score encore provisoire faute de votes suffisants.
SpaceXAI place deux versions sous le nom Grok Imagine 2.0 : la plus récente, elle aussi provisoire, se hisse en quatrième position. Celle datée du 1er août continue de perdre du terrain à mesure que ses votes s’accumulent et se classe huitième. Entre les deux, MAI-Image-2.6 cède une place, cinquième. Arena attribue d’ailleurs la même fourchette de rangs, de 4 à 6, au modèle de Microsoft, à celui de Google et au nouveau Grok. Les trois restent donc très proches à ce stade.
Ces nouvelles entrées repoussent les autres modèles plus loin dans le classement : Reve 2.1 et Reve 2.0 perdent chacun deux places, septième et dixième, tout comme Muse Image, le modèle de Meta, désormais neuvième. Seedream 5.0 Pro, le modèle de ByteDance, quitte quant à lui le top 10 pour la douzième place.
Le top 10 des modèles de génération d’images à partir de texte en octobre 2026 (voir image de une) :
- GPT Image 2.5 Sunburst (OpenAI) : 1 425 (score Elo)
- GPT Image 2.5 Flare (OpenAI) : 1 398
- GPT Image 2 medium (OpenAI) : 1 383
- Grok Imagine 2.0 (SpaceXAI) : 1 334
- MAI-Image-2.6 (Microsoft) : 1 332
- Nano Banana 2.1 (Google) : 1 328
- Reve 2.1 (Reve) : 1 302
- Grok Imagine 2.0, version du 1er août (SpaceXAI) : 1 294
- Muse Image (Meta) : 1 274
- Reve 2.0 (Reve) : 1 269
En édition, avec une image ou plusieurs, le podium ne bouge pas
Le classement de l’édition, qui juge la capacité d’un modèle à modifier un visuel existant selon une consigne, reprend le même trio d’OpenAI. Le nouveau Grok Imagine 2.0 et Nano Banana 2.1 complètent le top 5, devant MAI-Image-2.6. Krea y fait son apparition avec Krea 3 Ultra, la déclinaison la plus poussée de son nouveau modèle maison. Il pointe au huitième rang avec à peine plus de 2 600 votes.
Le top 5 de l’édition à partir d’une image en octobre 2026 :
- GPT Image 2.5 Sunburst (OpenAI) : 1 514 (score Elo)
- GPT Image 2.5 Flare (OpenAI) : 1 481
- GPT Image 2 medium (OpenAI) : 1 461
- Grok Imagine 2.0 (SpaceXAI) : 1 439
- Nano Banana 2.1 (Google) : 1 426

Arena tient aussi un tableau distinct pour l’édition multi-images, où la consigne s’appuie sur plusieurs visuels fournis en entrée. Les trois modèles d’OpenAI y conservent leur rang, mais la suite change. Krea 3 Ultra se classe quatrième, devant Nano Banana 2.1, tandis que Seedream 5.0 Pro, absent du top 10 en génération, remonte à la sixième place. Google y aligne quatre modèles, alors que ni SpaceXAI ni Microsoft n’apparaissent parmi les dix premiers.
Le top 5 de l’édition à partir de plusieurs images en octobre 2026 :
- GPT Image 2.5 Sunburst (OpenAI) : 1 518 (score Elo)
- GPT Image 2.5 Flare (OpenAI) : 1 479
- GPT Image 2 medium (OpenAI) : 1 453
- Krea 3 Ultra (Krea) : 1 435
- Nano Banana 2.1 (Google) : 1 432

Comment Arena établit ses classements d’images
Arena fonctionne par duels à l’aveugle. Pour une même consigne, l’internaute reçoit deux images produites par des modèles anonymes et désigne celle qu’il préfère, les noms n’étant révélés qu’après son vote. Ces préférences alimentent un score calqué sur le système Elo des échecs, dans lequel battre un adversaire mieux noté fait davantage progresser qu’un succès contre un modèle moins bien placé. Chaque score s’accompagne d’une marge d’erreur et d’une fourchette de rangs, qui se resserrent au fil des votes. Les modèles arrivés récemment, dont la position peut encore évoluer sensiblement, portent la mention « preliminary ». Le tableau multi-images regroupe, lui, les duels dans lesquels plusieurs visuels ont été soumis au départ.
Les meilleurs générateurs d'images par IA
Midjourney
Craiyon

Bing Image Creator